数据作品 · DATA
医院招标投标数据采集与分析
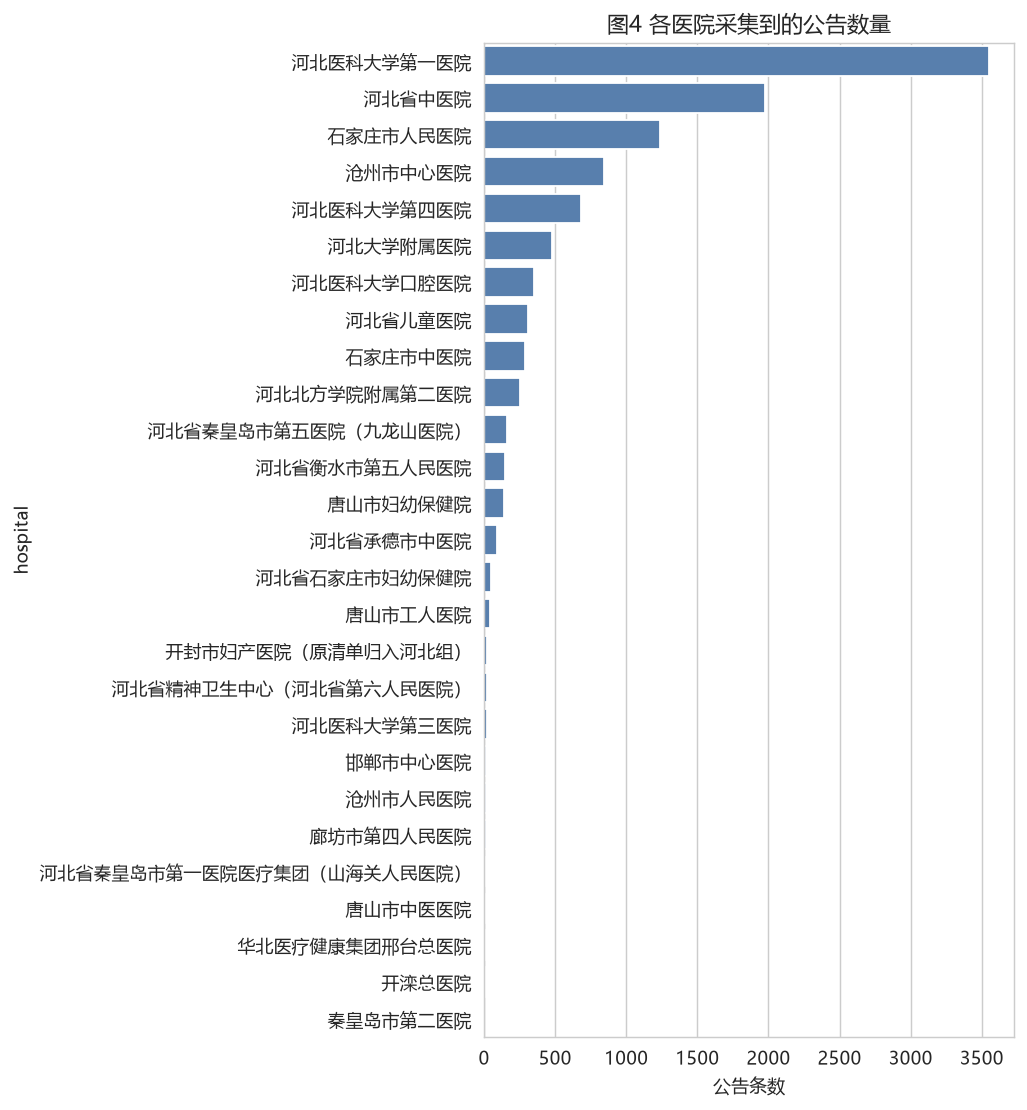
27 个医院官网、10709 条公告:从采集、清洗到五类建模,把散落的招标信息做成一张能横向比较、能建模的数据集。
项目概览
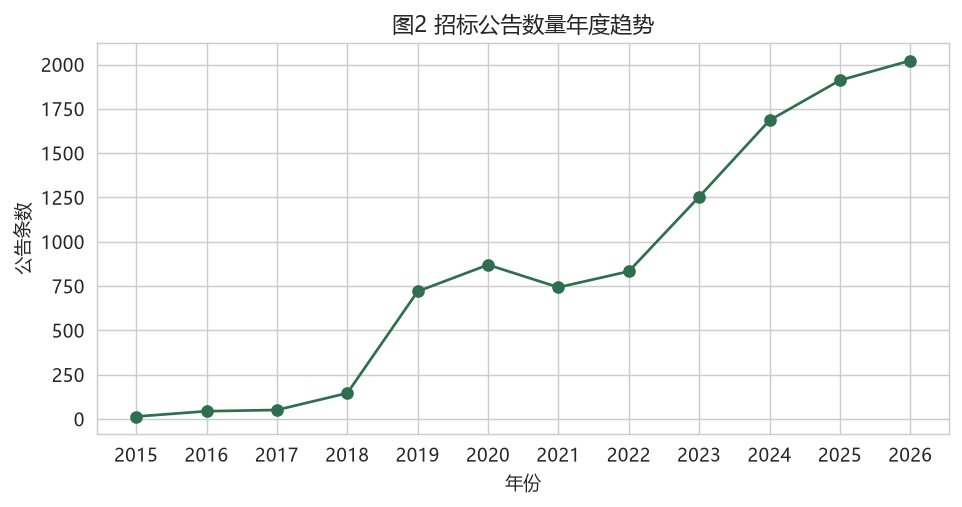
采集 → 清洗 → 建模任务来自《大数据挖掘综合实践》实验周:指定 25 条医院记录(去重后 22 家官网),按《信息采集字典》口径采集「招标 / 采购 / 中标 / 公示」栏目;数据不足时用备用名单补采,最终覆盖 27 家医院官网。入库公告 10709 条,时间从 2014-04-25 到 2026-10-12;同时落盘 9579 份详情页正文和 2830 个网页附件,剔除 1332 条与招标无关的公告。
10709
入库公告(条)
27
覆盖医院官网(家)
9579
详情页正文(份)
2830
网页附件(个)
1332
剔除无关公告(条)
数据是怎么收进来的
配置驱动 · 两阶段20 多个医院站点没有统一模板,逐个写死解析器不可维护。所以把站点差异集中到配置里,流程拆成两个阶段,再用一层缓存兜住重复请求。
两阶段:先发现链接,再抓详情
- 第一阶段翻列表页,按站点配置发现公告链接;第二阶段进详情页抽正文、下载附件、整理成字典要求的字段。
- 站点差异集中在
sites.py的采集适配配置里,改一个站点只影响该站点。 - 加限速、User-Agent 轮换、超时与指数退避重试;403 / 429 触发长时间冷却。同域名请求间隔和单域名并发上限都可配。
- 所有页面落盘缓存,同一 URL 只请求一次;调试解析规则不产生额外请求,也能用已落盘的详情页重跑字段、不联网。
正文抽取换了一种打分方式
最初用「取最长文本块」抽正文,结果在沧州、承德、唐山等站点上整页导航把正文淹没了。后来改成按非链接文字量打分:先切块,再挑链接密度低、有效文字多的块作为正文。清洗口径是剔除人事招聘、预决算公开、医院简介、政策文件、健康科普等与招标无关的公告,共 1332 条。
采集合规
只采集公开发布的招标投标公告与其附件,不涉及任何登录或非公开数据。限速、缓存、退避重试都是为了不给对方站点添麻烦。
数据里看到了什么
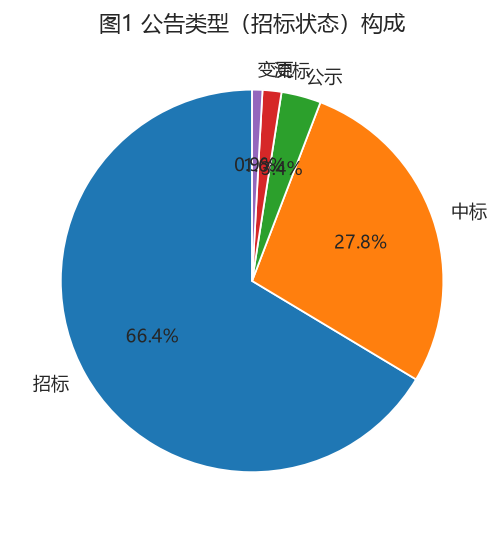
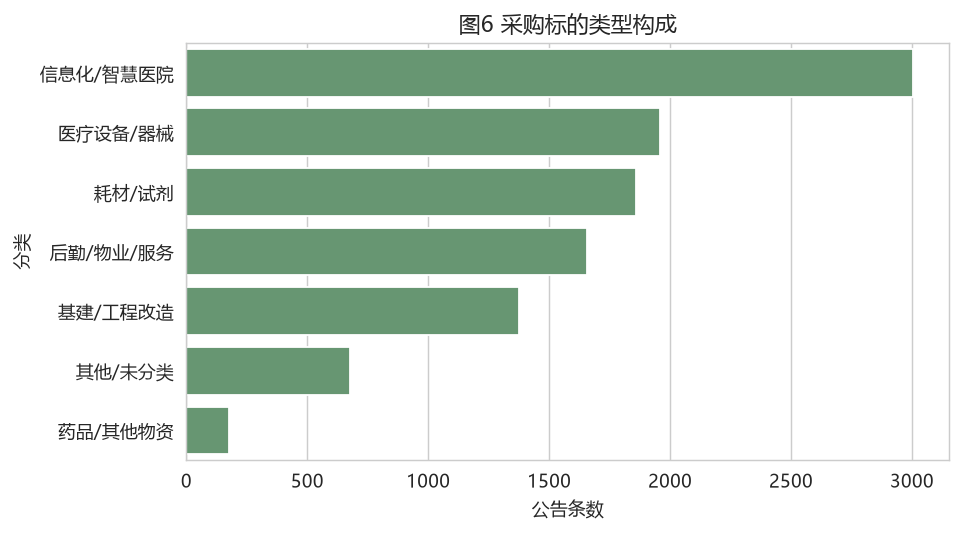
8 张图下面 8 张图来自报告与建模产出,图注按原图内容写,点开可看大图。
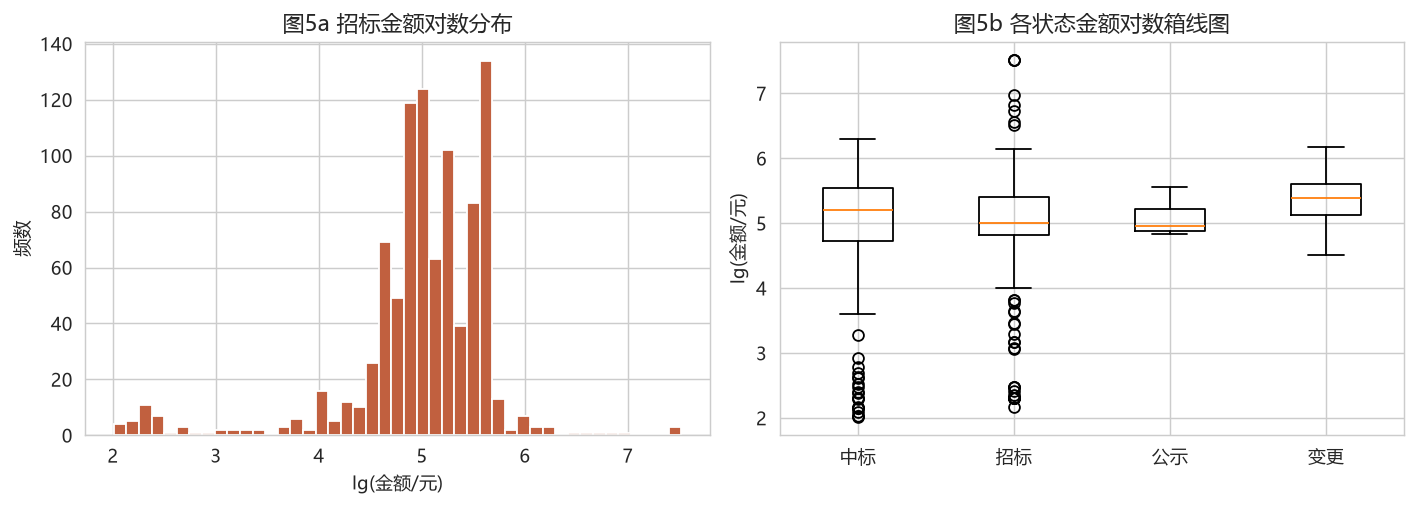
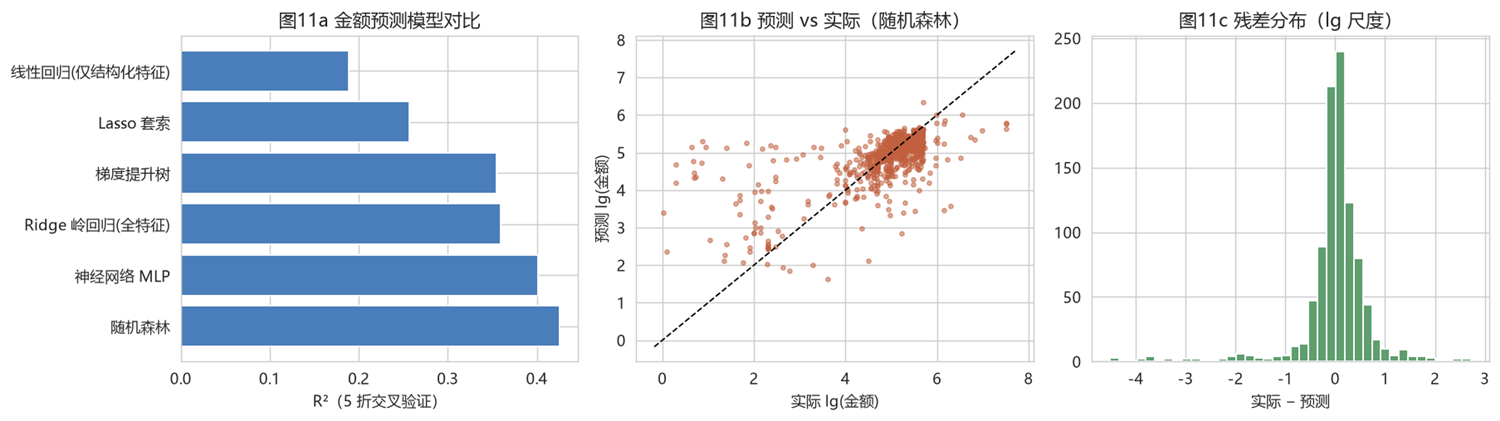
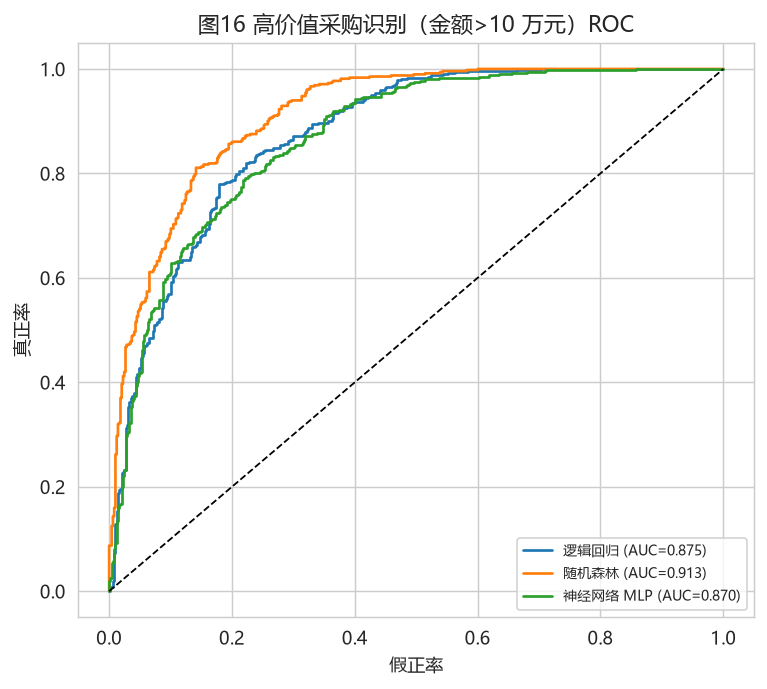
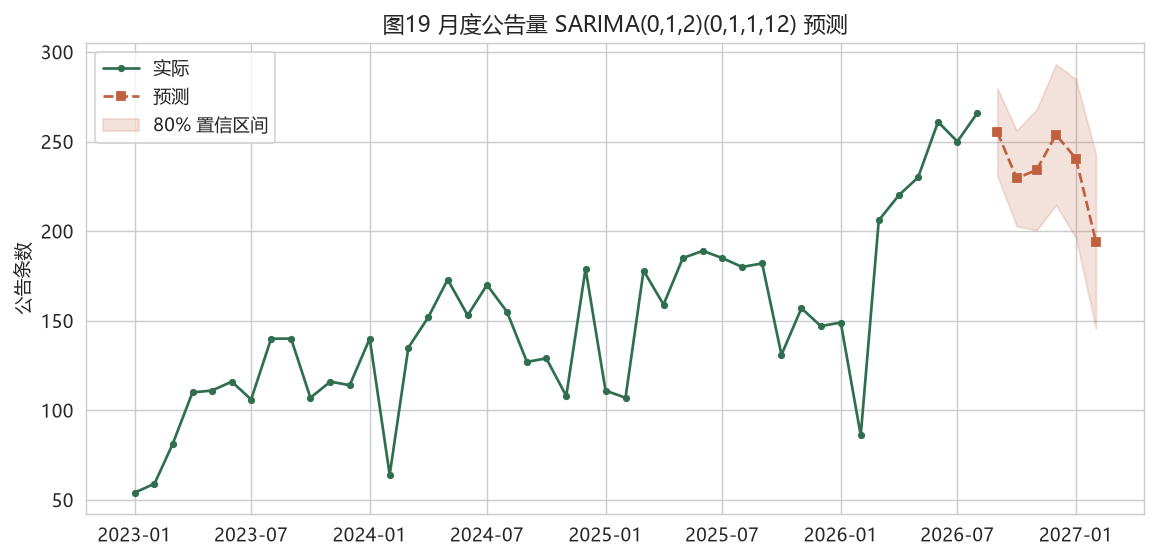
数据口径与结论
五类建模口径先定清楚
入库 10709 条公告,来自 27 家医院官网,覆盖 2014-04-25 至 2026-10-12;详情页正文 9579 份、网页附件 2830 个;剔除人事招聘、预决算公开、医院简介、政策文件、健康科普等无关公告 1332 条。所有结论都建立在这套口径上。
五类建模,各留一句结论
- 金额回归:目标取对数,六模型五折交叉验证。随机森林 R²=0.425(对数尺度 RMSE=0.729),仅结构化特征的线性回归只有 0.189——说明「买的是什么」这段文本确实有增量信息。
- 标的类型分类:只用正文、剔除标签列,做 7 分类,准确率约 0.71、宏平均 F1≈0.62;朴素贝叶斯明显落后,神经网络训练曲线平滑收敛。
- 高价值采购识别:金额 > 10 万元二分类,同分布 AUC≈0.91;时间外推(2024 前训练、2025 后预测)降到 0.66。
- 流标风险识别:随机五折 AUC 0.99,按医院分组验证降到 0.95、PR-AUC 从 0.89 掉到 0.62,且模型排序发生反转——一个真实的分布偏移案例。
- 聚类与时序:KMeans + 轮廓系数定簇数、LDA 取主题;月度公告量用 SARIMA 按 AIC 选阶并外推 6 个月(残差 Ljung-Box p=0.025,仍有残余自相关,报告里已如实说明)。
三个防坑点
- 防标签泄漏:招标状态、标的类型本身就是规则从标题打上的标签,不能当特征——分类任务只用正文。
- 防数字泄漏:金额是从正文数字抽的,建模文本统一抹除数字,否则回归会退化成「把数字再抄一遍」。
- 防验证失真:存在强分组结构时随机交叉验证会高估泛化能力,所以并列汇报「随机 5 折」与「按医院分组 / 按时间外推」两种结果。
我做了什么,没做到什么
个人贡献 · 限制个人贡献
- 把参考脚本重写成「配置驱动 + 两阶段 + 缓存」的采集结构,站点差异集中进配置层。
- 正文抽取从「取最长文本块」改成「按非链接文字量打分」,解决沧州、承德、唐山等站点的正文被导航淹没问题。
- 设计建模口径与验证方式,把三个防坑点写进流程;用脚本按模板生成实验报告。
- 用一键脚本串起采集、字段抽取、分析、报告与自检,换台机器也能复现。
限制与下一步
- 只采公开发布的公告与附件,不碰登录数据;部分站点结构变动时需要补配置。
- 金额从正文数字抽取,少数异常高值需人工复核(报告里单列了金额异常高值 TOP 20 复核清单)。
- 分布偏移很明显:高价值采购识别的时间外推 AUC 从 0.91 降到 0.66,流标风险按医院分组后 PR-AUC 从 0.89 降到 0.62。
- SARIMA 残差仍有自相关(Ljung-Box p=0.025),外推只能当趋势参考,不当精确预测。
- 下一步:给抓取层补单元测试,把列表解析抽成独立模块。
技术栈
够用就好
Python配置驱动采集落盘缓存限速与退避重试
正文抽取pandas / numpyscikit-learnmatplotlib
JSONL / CSV / ExcelWord 报告一键复现脚本
采集、清洗、建模、出报告都在同一套目录里;交付物是数据集、图表、实验报告与能复现的脚本,而不是一次性结果。